Reagowanie na incydenty i zarządzanie podatnościami w Security+
Cykl życia IR, higiena forensyczna, podstawy threat huntingu i praktyczna pętla vulnerability management zgodna z domeną 4 egzaminu SY0-701.
Domena 4 egzaminu SY0-701 to miejsce, gdzie teoria bezpieczeństwa zderza się z operacyjną rzeczywistością. W każdej dojrzałej organizacji równolegle działają dwa programy: vulnerability management wykrywa i zamyka słabe punkty, zanim napastnicy zdążą je wykorzystać; incident response (IR) reaguje na naruszenie, gdy prewencja jednak zawiedzie. Egzamin nie wymaga, abyś prowadził zmianę w SOC, ale oczekuje, że rozpoznasz, która faza którego procesu jest opisana w danym scenariuszu — i unikniesz pułapek mylącej scanning z pen testingiem, containment z eradication czy termin powiadomień compliance z kamieniem milowym IR.
Ten wpis omawia oba cykle życia z wystarczającą głębokością, by odpowiadać na pytania scenariuszowe, a przy tym obejmuje zagadnienia forensics hygiene i threat huntingu, które pojawiają się w tej samej domenie.
Dlaczego te dwa programy idą w parze
Vulnerability management jest proaktywny i cykliczny. Incident response jest reaktywny i linearny — przynajmniej do momentu, gdy kolejny incydent uruchamia następny cykl. W praktyce oba się wzajemnie zasilają: analiza przyczyn źródłowych po incydencie często ujawnia brakującą łatkę, błędną konfigurację lub lukę w detekcji, którą vulnerability management powinien był zamknąć. I odwrotnie: krytyczne CVE z aktywnym exploitem na serwerze eksponowanym w internecie może uruchomić awaryjny workflow IR, jeśli aktywność eksploatacyjna jest już widoczna w logach.
Egzamin czasami łączy oba programy w jednym pytaniu — „po zamknięciu incydentu zespół zauważył, że ta sama usługa miała otwarte krytyczne znalezisko ze skanu sprzed kwartału" — i pyta, który program zawiódł i w którym miejscu. Odpowiedź brzmi: vulnerability management — znalezisko istniało, remediacja się opóźniła, a atakujący znalazł je jako pierwszy.
Pętla vulnerability management
Vulnerability management należy traktować jako zamkniętą pętlę, a nie jednorazowy projekt. Przebiega od discovery przez scanning, analizę, remediację i walidację — a następnie wraca do punktu startowego. Każdy etap ma właściwą odpowiedź i kuszący skrót.
Discovery to miejsce, gdzie wiele programów zawodzi, zanim się zaczną. Nie można chronić zasobów, o których się nie wie, że istnieją. Tylko połączenie skanowania sieci, inwentaryzacji agentowej, chmurowych API do wykrywania zasobów i reconciliacji CMDB daje pełny obraz — każde pojedyncze źródło pomija jakąś kategorię. Shadow IT — działy uruchamiające narzędzia SaaS lub maszyny wirtualne bez przeglądu przez security — to powtarzający się scenariusz egzaminacyjny, ponieważ nieewidencjonowane zasoby nigdy nie trafiają do kolejki skanowania. Gdy baza danych pojawia się w internecie bez wpisu w CMDB, pierwszym krokiem nie jest „załataj bazę danych", lecz „przypisz właściciela". Bez accountability łatki i wyjątki nie mają nikogo, kto mógłby je zatwierdzić lub śledzić.
Scanning generuje surowe znaleziska. Skany uwierzytelnione logują się do celu i ujawniają problemy widoczne dopiero po zalogowaniu; skany nieuwierzytelnione pomijają dużą część krajobrazu ryzyka. Stwierdzenie w pytaniu „zero krytycznych znalezisk na serwerze webowym" nie potwierdza bezpieczeństwa serwera — może oznaczać, że skan nigdy nie był uwierzytelniony.
Analiza dodaje kontekst do surowych wyników CVE. CVSS 9.8 na izolowanym laboratorium wewnętrznym to coś zupełnie innego niż ta sama ocena na bramie płatniczej z aktywnym exploitem w sieci. Priorytetyzacja oparta na ryzyku uwzględnia dostępność exploita, krytyczność zasobu, ekspozycję sieciową i kontrole kompensujące, które mogą zmniejszyć pilność. Egzamin często przedstawia dwie krytyczne podatności przychodzące tego samego dnia i pyta, którą zająć się najpierw. Właściwa odpowiedź uzasadnia priorytet wpływem biznesowym i prawdopodobieństwem eksploatacji — nie samym CVSS.
Remediacja może oznaczać patchowanie, hardening konfiguracji, segmentację sieciową lub kontrole kompensujące, gdy patchowanie jest niemożliwe. Systemy legacy OT certyfikowane przez producentów tylko raz w roku to kanoniczne ograniczenie. Akceptacja ryzyka jest uzasadniona, gdy koszt remediacji faktycznie przekracza ryzyko, ale egzamin oczekuje udokumentowanej decyzji z nazwanym właścicielem i datą przeglądu. Bezterminowa akceptacja bez daty wygaśnięcia to naruszenie governance w przebraniu kontroli.
Po remediacji należy ponownie zeskanować, by potwierdzić, że poprawka zamknęła znalezisko. Wyniki należy przedstawiać w języku ryzyka zrozumiałym dla biznesowych interesariuszy — „zmniejszyliśmy zewnętrzną powierzchnię ataku na infrastrukturę płatniczą" — a nie w arkuszu CVE ID.
Cykl życia incident response
CompTIA definiuje sześciofazowy proces IR, a egzamin nagradza kandydatów, którzy potrafią rozpoznać, którą fazę opisuje dany scenariusz — nie tylko recytować sekwencję w kolejności. Fazy to: Preparation → Detection and Analysis → Containment → Eradication → Recovery → Lessons Learned.
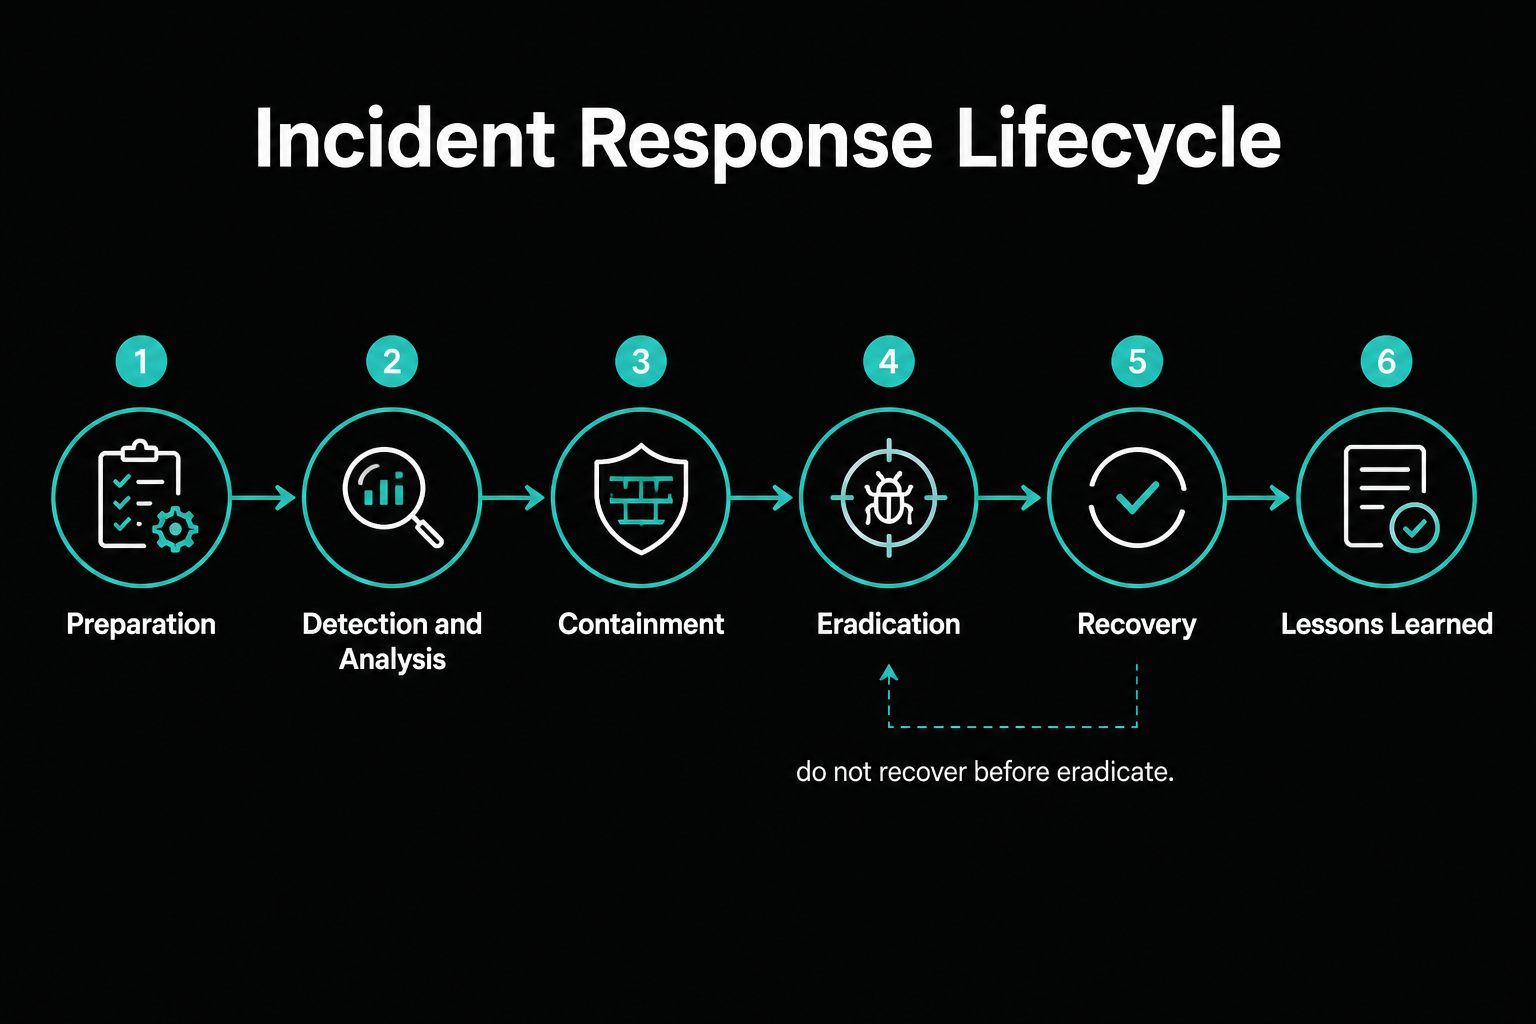
Krótka uwaga o frameworkach IR: SY0-701 testuje ten model fazowy, a odpowiedzi egzaminacyjne powinny pasować do jego słownictwa. NIST SP 800-61 Rev.3 — opublikowany w 2024 roku — reorganizuje swoje wytyczne, mapując działania IR na funkcje NIST Cybersecurity Framework 2.0 (Govern, Identify, Protect, Detect, Respond, Recover). W praktyce te same działania pojawiają się w obu frameworkach; w odpowiedziach egzaminacyjnych używaj sześciofazowego języka CompTIA, a nie etykiet funkcji CSF, aby uniknąć pomyłek terminologicznych.
Preparation: inwestycja, której nikt nie widzi
Preparation następuje przed dotknięciem środowiska przez jakikolwiek incydent. Obejmuje udokumentowane playbooki, drzewa kontaktów uwzględniające dział prawny, PR, ubezpieczenia, kierownictwo wykonawcze i łączników z organami ścigania, zwalidowane narzędzia forensyczne, procedury postępowania z dowodami oraz ćwiczenia tabletop, które ujawniają luki decyzyjne zanim zrobią to prawdziwi atakujący. Odkrycie podczas tabletop, że nikt nie ma uprawnień do wyłączenia produkcyjnego sklepu e-commerce o 2 w nocy, to znalezisko etapu Preparation. Przypisanie tej decyzji konkretnemu decydentowi z osobą zastępującą to działanie Preparation. Odkrycie tego podczas żywego ransomware to kryzys containment.
Słabą ścieżką jest traktowanie Preparation jako projektu dokumentacyjnego. Playbook, którego nikt nie czytał, i lista kontaktów, których nikt nie testował, to papier, a nie gotowość. Mocna ścieżka to system ćwiczony, przeglądany i aktualizowany w rytmie, który utrzymuje go aktualnym ze środowiskiem.
Detection and Analysis: potwierdź, zanim zadziałasz
Detection pochodzi z alertów SIEM, telemetrii EDR, zgłoszeń użytkowników, feedów threat intelligence i anomaly detection. Analysis potwierdza, czy alert reprezentuje prawdziwy incydent, określa zakres i identyfikuje dotknięte systemy i dane — zanim ktokolwiek podejmie działania zakłócające. Alert IDS to detection, a nie sygnał do containment. Następnym krokiem jest analiza: korelacja z innymi źródłami logów, wykluczenie false positive i określenie zakresu. Izolacja hosta przed zrozumieniem, czy jest to patient zero, czy ofiara późnego etapu ataku, może rozsypać ślad forensyczny i ostrzec atakującego o zamknięciu dostępu, zanim zmapujesz całą kampanię.
Przydatne źródła podczas analizy: skorelowane zdarzenia SIEM, telemetria procesów i plików EDR, logi tożsamości pokazujące anomalie uwierzytelniania i zmiany uprawnień, logi DNS i proxy pokazujące beaconing C2, audit trails chmury pokazujące nieoczekiwane wywołania API oraz logi bramy email, jeśli phishing był inicjalnym wektorem. Słabą ścieżką jest działanie na podstawie pojedynczego alertu bez korelacji. Mocną ścieżką jest najpierw zbudowanie obrazu zakresu: ile systemów, które konta, do jakich danych mógł uzyskać dostęp atakujący.
Containment: zatrzymaj krwawienie
Containment ogranicza szkody bez konieczności usunięcia zagrożenia. Izolacja hosta od sieci, blokowanie IP lub domeny C2 na firewallu, wyłączenie skompromitowanego konta i kwarantanna VLAN — to wszystko działania containment. Rozróżnienie od eradication jest celowe: containment to „zatrzymaj rozprzestrzenianie się", a nie „wyczyść środowisko".
EDR wykrywa lateral movement ze stacji roboczej w VLAN finansów. Izolacja sieciowa stacji roboczej zachowuje artefakty pamięci dla forensics. Natychmiastowe wyłączenie każdego potencjalnie powiązanego konta może ostrzec atakującego o zamknięciu dostępu, zanim zmapujesz całą kampanię. Egzamin oczekuje, że wyważysz preservację dowodów z ryzykiem dalszego rozprzestrzeniania — i rozpoznasz, że ani containment, ani eradication nie powinny uruchamiać recovery, zanim oba kroki zostaną potwierdzone jako zakończone.
Słabą ścieżką jest natychmiastowe reimagowanie stacji roboczej, bo „to naprawia problem". Reimaging to eradication na jednym endpoincie. Jeśli kanał C2 atakującego, phishingowy email dostarczający inicjalny dostęp i podatność VPN użyta do eskalacji uprawnień pozostają otwarte, wyczyściłeś jedną maszynę i zostawiłeś drzwi otwarte.
Eradication: zamknij drzwi naprawdę
Eradication całkowicie usuwa zagrożenie — usuwa malware, usuwa konta utworzone przez atakującego, czyści mechanizmy persistencji (scheduled tasks, klucze rejestru, web shelle na serwerze aplikacyjnym), łata wykorzystaną podatność i unieważnia dane uwierzytelniające, które atakujący mógł zebrać. Pułapka egzaminacyjna polega na założeniu, że eradication na jednym urządzeniu równa się eradication w środowisku. Reimagowana stacja robocza z niezałatanym appliance VPN nadal zapewniającym inicjalny dostęp oznacza, że kampania trwa z następnego przyczółka.
Recovery: przywróć, zwaliduj, potem podłącz
Recovery przywraca systemy do normalnego działania z znanych dobrych backupów lub czystych rebuilds, a następnie waliduje, że są załatane i monitorowane, zanim wrócą do produkcji. W zakresie infrastruktury odtwarzania — hot sites, warm sites, cold sites, kompromisy RTO versus RPO — zapoznaj się z wpisem o ochronie danych i odporności, gdzie te poziomy są omówione w całości.
Wymagania dotyczące powiadomień regulacyjnych przecinają się z czasem recovery. Zgodnie z GDPR naruszenie danych osobowych stwarzające ryzyko dla praw i wolności osób fizycznych musi zostać zgłoszone organowi nadzorczemu w ciągu 72 godzin od momentu uświadomienia sobie przez organizację jego wystąpienia — nie w ciągu 72 godzin od zakończenia IR. HIPAA ma równoległe obowiązki dla covered entities i business associates, z harmonogramami zależnymi od kategorii naruszenia i tego, czy dotyczyło ono chronionych informacji zdrowotnych. Żaden z tych frameworków nie czeka na zakończenie recovery. Scenariusz egzaminacyjny opisujący naruszenie wykryte w poniedziałek i pytający, jakie działanie jest wymagane do końca tygodnia, oczekuje, że zidentyfikujesz powiadomienie regulacyjne obok kroków IR, a nie tylko remediację techniczną.
Słabą ścieżką jest ogłoszenie recovery jako zakończonego w chwili, gdy systemy wracają online. Mocna ścieżka obejmuje weryfikację łatki wektora wejścia, sweep persistencji potwierdzający brak artefaktów atakującego, walidację aktywnego monitorowania przed podłączeniem do produkcji oraz wyraźne potwierdzenie, że integralność backupu została zweryfikowana przed przywróceniem.
Lessons Learned: faza, którą zespoły pomijają
Post-incident review dokumentuje oś czasu, przyczynę źródłową, co zadziałało, co zawiodło i action items z właścicielami i datami. Zasila Preparation zaktualizowanymi playbootami i ćwiczonymi drzewami kontaktów oraz vulnerability management nowymi celami skanowania, dostosowanymi SLA remediacji i poprawionymi bazami konfiguracji. Pomijanie Lessons Learned, bo zespół jest zajęty, gwarantuje powtórzenie tego samego incydentu z tymi samymi lukami. Scenariusze egzaminacyjne pokazujące ticket zamknięty natychmiast po recovery i pytające, czego brakowało, zawsze lądują na tej samej odpowiedzi: Lessons Learned — i organizacyjne usprawnienie, które by po nim nastąpiło.
Forensics hygiene: zbierz, zanim skażesz
SY0-701 nie wymaga umiejętności forensycznych, ale testuje koncepcyjne postępowanie z dowodami. Order of volatility rządzi sekwencją zbierania: najpierw najbardziej ulotne, najpóźniej najmniej ulotne. Rejestry CPU i cache znikają przy wyłączeniu zasilania; RAM znika przy restarcie; stan sieci i aktywne połączenia zmieniają się w ciągu minut; uruchomione procesy i otwarte uchwyty plików są następne; dysk jest stosunkowo stabilny; zdalne systemy logowania i archiwizacji mają opóźnienie, ale trwają najdłużej. Scenariusz, w którym technik helpdesk zrestartował serwer, by naprawić problem wydajnościowy, testuje order of volatility — dowody malware rezydującego w pamięci zostały zniszczone przed zbieraniem. Odpowiedź wymienia, co zostało utracone, a nie czy restart był rozsądnym krokiem diagnostycznym.
Chain of custody wymaga dokumentowania każdego przekazania dowodów: kto je zebrał, kiedy, gdzie były przechowywane i kto miał do nich dostęp. Hashowanie dowodów SHA-256 przed i po zbieraniu dowodzi integralności. Write blockery zapobiegają modyfikacji dysku podczas obrazowania. Luki w chain of custody mogą unieważnić dowody w postępowaniu prawnym — egzamin testuje to w pytaniach „co sprawiłoby, że dowód byłby niedopuszczalny".
Threat hunting: hipoteza przed zapytaniem
Threat hunting jest proaktywny i oparty na hipotezach, co odróżnia go od wszystkiego innego w stosie detekcji. Automatyczne alerty są reaktywne i oparte na regułach — uruchamiają się, gdy znane wzorce pasują. Vulnerability scanning znajduje słabości, nie aktywnych przeciwników. Penetration testing symuluje atak w określonych ramach czasowych. Hunting zaczyna się od teorii — „atakujący mogą używać living-off-the-land binaries w VLAN finansów" — i przeszukuje telemetrię w poszukiwaniu behawioralnych wskaźników, które potwierdzają lub obalają tę teorię bez czekania na sygnaturę.
Klasyczny scenariusz huntingu: żadna reguła SIEM się nie uruchamia, ale hunter zauważa powershell.exe spawningowany z winword.exe na trzech stacjach roboczych finansów w tej samej godzinie. Ta korelacja wymagała ludzkiej hipotezy, a nie automatycznej reguły. Gdy hunt potwierdza aktywny kompromis, przekazuje do cyklu IR w fazie Detection and Analysis. Gdy znajduje systemowe luki bez aktywnego kompromisu, produkuje action items dla vulnerability management.
Podsumowanie pułapek egzaminacyjnych
| Pułapka | Weryfikacja |
|---|---|
| „Cotygodniowe uwierzytelnione skany = incident response" | To jest vulnerability management — proaktywny i cykliczny, nie reaktywny |
| „Skan znalazł zero krytycznych, serwer jest bezpieczny" | Skany nieuwierzytelnione pomijają problemy widoczne po zalogowaniu; żaden scanner nie znajdzie zero-dayów ani wad logicznych |
| „Wynik CVSS określa kolejność patchowania" | Prawdopodobieństwo eksploatacji, krytyczność zasobu i ekspozycja mają wyższy priorytet niż surowy wynik |
| „Akceptacja ryzyka oznacza, że możemy przestać go śledzić" | Ważna tylko z nazwanym właścicielem, udokumentowanym uzasadnieniem i datą przeglądu |
| „Alert IDS uruchomił się — natychmiast izoluj hosta" | Analiza poprzedza containment; najpierw ustal zakres |
| „Reimagowałem laptop — incydent jest zamknięty" | Eradication na jednym endpoincie z otwartym wektorem dostępu oznacza, że atakujący nadal jest w środku |
| „Recovery jest zakończone, gdy systemy są online" | Najpierw załataj wektor wejścia, zrób sweep persistencji, zwaliduj monitoring |
| „Powiadomienie GDPR czeka na zakończenie IR" | Zegar 72 godzin startuje w momencie uświadomienia sobie naruszenia, nie zamknięcia incydentu |
| „Hot/warm/cold site to decyzja kosztowa" | Poziom recovery musi pasować do zobowiązania RTO — patrz wpis o ochronie danych |
| „Threat hunting to zaawansowane wyszukiwanie w SIEM" | Hunting jest oparty na hipotezach; SIEM jest oparty na regułach — różne punkty startowe |
| „Lessons Learned są opcjonalne dla drobnych incydentów" | Każdy incydent zasila Preparation; pominięcie gwarantuje nawrót |
Rama końcowa
Vulnerability management i incident response to nie konkurujące programy — to ta sama postawa bezpieczeństwa oglądana z dwóch różnych horyzontów czasowych. Vulnerability management patrzy w przyszłość: znajdź słabość przed atakującym. Incident response patrzy w teraźniejszość: ile szkód nastąpiło i jak to zatrzymać? Lessons Learned patrzy wstecz: co zmieniło się w środowisku, co na to pozwoliło, i co trzeba zamknąć przed następną kampanią?
Zabierz ze sobą na egzamin jedno diagnostyczne pytanie do każdego scenariusza dotyczącego któregokolwiek z tych programów: „Czy to jest proaktywne czy reaktywne, i czy jestem proszony o działanie czy o analizę?" To pytanie rozwiązuje większość pytań o kolejność faz i większość pomyłek między scanning a pen testingiem, zanim przeczytasz opcje odpowiedzi.
Uzupełniające lektury: wpis o ochronie danych i odporności w zakresie decyzji dotyczących backupu, lokalizacji i infrastruktury recovery pod IR recovery, oraz wpis o IAM, monitorowaniu i hardeningu w zakresie kontroli SIEM, EDR i logowania zasilających fazę Detection and Analysis.