Ochrona danych i odporność: backupy, ciągłość i klasyfikacja
Jak SY0-701 oczekuje ochrony danych at rest/in transit/in use, klasyfikacji, zarządzania kluczami oraz utrzymania operacji dzięki backupom i strategii site.
Atakujący nie gonią diagramów VLAN — gonią rekordy. Regulatorzy i klienci nie obchodzi, że firewall miał sprytną regułę, jeśli dane payroll wychodzą drzwiami. Awaria karze tę samą instytucję z innego kąta: brak przetestowanych backupów, brak planu ciągłości, brak site odzyskania — i ransomware staje się końcem biznesu zamiast złego tygodnia.
Domena 3 SY0-701 oczekuje, że ochronisz dane w każdym stanie, sklasyfikujesz je poprawnie, zarządzisz kluczami kryptograficznymi, które je chronią, i utrzymasz operacje, gdy systemy padną. Ten wpis prowadzi pełny łuk: stany danych i klasyfikacja, key management i sanitizacja nośników, słownictwo ciągłości i strategia site’ów oraz ransomware walkthrough, który robi z tego konkret.
Dane: trzy stany, jedna historia bezpieczeństwa
Kontrolki muszą pasować do tego, jak dane istnieją w momencie ich zastosowania. Data at rest leży na dysku, taśmie, object storage, w bazach, telefonach i targetach backupu. Kanoniczna kontrolka to szyfrowanie — full-disk, volume albo file-level — plus ACL i bezpieczeństwo fizyczne nośnika. Stemy o skradzionym laptopie testują, czy FDE było włączone przed utratą, nie co zrobisz z polityką haseł potem. FDE oznacza, że dysk wyjęty ze sprzętu jest nieczytelny bez klucza; zmiana hasła po zniknięciu urządzenia nie chroni tego, co już jest na dysku.
Data in transit porusza się po sieciach: sesje web, API, e-mail, tunele VPN, replikacja site-to-site. Oczekiwane kontrolki to TLS 1.2+ i IPsec; pułapka to organizacja z HTTPS na brzegu, podczas gdy ruch east-west wewnątrz zostaje plaintextem na flat network. Atakujący, który zpivotował za edge, czyta wszystko, co te certyfikaty miały chronić.
Data in use jest aktywnie przetwarzane — rejestry CPU, pamięć, żywe pipeline’y analityczne, sesja przeglądarki agenta supportu. Kontrolki są tu trudniejsze i pojawiają się na średniej głębokości. Least privilege ogranicza, które procesy dotykają wrażliwych pól; polityki DLP blokują eksport schowka z aplikacji web i download na prywatne urządzenia. Na zaawansowanym końcu pojawiają się koncepty confidential computing — Trusted Execution Environments izolujące workload od hypervisora sprzętowo — jako cel rozpoznania, nie zadanie konfiguracyjne.
| Stan | Przykład | Główne rodziny kontrolek |
|---|---|---|
| At rest | File server, bucket S3, storage telefonu | Szyfrowanie, ACL, klasyfikacja, secure disposal |
| In transit | API HTTPS, replikacja site-to-site | TLS/IPsec, zarządzanie certyfikatami, bezpieczne protokoły |
| In use | Żywe zapytanie, screen share, trening ML | Least privilege, DLP, izolacja, monitoring |
Czytaj tabelę jako ćwiczenie mapowania. Gdy stem mówi, w jakim stanie są dane, wskazuje rodzinę kontrolek. „Co najlepiej chroni data in use?” nie pyta o TLS.
Klasyfikacja, handling i klucze, które chronią
Klasyfikacja etykietuje informacje według wrażliwości i obowiązku prawnego. Nazwy tierów różnią się — public, internal, confidential, restricted — ale efekt praktyczny jest zawsze ten sam: klasyfikacja odpowiada, kto może sięgnąć do rekordu, czy szyfrowanie jest obowiązkowe, czy dane mogą opuścić geografię oraz jakie są reguły retencji i utylizacji. Deck z rady nadzorczej oznaczony jako confidential nie powinien żyć w osobistym cloud sync pracownika; publiczne broszury marketingowe mogą. To oczywiste na głos i łatwe do przeoczenia pod presją czasu egzaminu.
Gdy sklasyfikujesz dane, musisz zarządzać kluczami, które je chronią — i tu SY0-701 oczekuje więcej niż „użyj AES-256”. Każdy realny system szyfrowania oddziela Data Encryption Key (DEK) od Key Encryption Key (KEK). DEK szyfruje dane; KEK szyfruje DEK, żebyś mógł rotować albo odwołać dostęp bez ponownego szyfrowania całego datasetu. Zniszcz lub zrotuj KEK, a DEK staje się nieczytelny — dane są kryptograficznie niedostępne bez dotknięcia pliku.
Gdzie te klucze żyją, wyznacza poziom assurance całego układu. Hardware Security Module (HSM) to odporne na manipulację urządzenie, które generuje, przechowuje i wykonuje operacje kryptograficzne bez eksportu materiału klucza w plaintext. HSM jest właściwą odpowiedzią, gdy stem żąda najwyższego assurance dla storage kluczy: środowiska klasyfikowane, infrastruktura płatnicza, rooty PKI. Key Management Service (KMS) — cloud-native odpowiednik — zarządza cyklem życia w skali: tworzenie, rotacja, odwołanie, audyt. Wiele cloud KMS podpiera root of trust HSM-em, więc dostajesz skalę operacyjną bez oddawania assurance sprzętowego. Pułapka egzaminu: traktować KMS i HSM jak synonimy. KMS zarządza kluczami w skali; HSM daje custody odporne na tamper. Często się łączą, ale rozwiązują inne problemy.
Sanitizacja nośników: co naprawdę mówi NIST SP 800-88
Gdy dysk opuszcza Twoją pieczę — emerytowany serwer, zwrócony leasing, darowizna albo zgubiony laptop — pytanie nie brzmi „czy wymazaliśmy”, tylko „czy wymazaliśmy na poziomie właściwym dla danych, które trzymał?”. NIST SP 800-88 definiuje trzy kategorie sanitizacji, a egzamin oczekuje dopasowania właściwej do scenariusza.
Clear stosuje technikę logiczną, zwykle overwrite przez własny interfejs odczytu/zapisu urządzenia. Wystarczy dla danych niskiej wrażliwości i dysków, które zostają pod kontrolą organizacji. Nie wystarczy dla nośnika wychodzącego poza Twoją granicę.
Purge stosuje techniki, które pokonują odzyskanie poza standardowym interfejsem urządzenia: cryptographic erase (zniszczenie klucza szyfrującego dane), overwrite narzędziami manufacturerskimi albo degaussing dla mediów magnetycznych. Purge to właściwy standard, gdy nośnik opuszcza organizację albo trzyma dane tieru confidential. Nowoczesne SSD czynią klasyczny multi-pass overwrite niewiarygodnym, bo wear-leveling rozrzuca dane po komórkach, do których logiczny zapis nie sięga. Cryptographic erase — zniszczenie DEK dysku self-encrypting — to jedyny praktyczny sposób osiągnąć wynik poziomu purge na flashu.
Destroy oznacza fizyczne zniszczenie: shredding, spalenie albo dezintegracja do rozmiaru cząstek, przy którym rekonstrukcja jest nieprawdopodobna. Dla najwyższych tierów wrażliwości albo nośników, których nie da się wiarygodnie wypurgować, Destroy jest jedyną akceptowalną metodą.
| NIST SP 800-88 | Metoda | Kiedy użyć |
|---|---|---|
| Clear | Logical overwrite | Niska wrażliwość; zostaje in-house |
| Purge | Crypto erase, degauss, advanced overwrite | Opuszcza org; tier confidential |
| Destroy | Fizyczny shredding / spalenie | Top-secret; nośnik nie do purge |
Pułapka: użyć Clear, gdy stem mówi, że dysk wraca do vendora albo idzie w darowiźnie. Urządzenie opuszczające custody i trzymające cokolwiek powyżej public potrzebuje Purge albo Destroy.
Słownictwo ciągłości i metryki, które napędzają decyzje
Terminy ciągłości biznesowej i IT zlewają się w praktyce; SY0-701 używa ich ze specyficznym znaczeniem. Business Continuity Plan (BCP) utrzymuje funkcje biznesowe przez zakłócenie — alternatywne miejsca pracy, procesy manualne, komunikacja kryzysowa. Disaster Recovery Plan (DRP) przywraca systemy IT po zdarzeniu. Business Impact Analysis (BIA) idzie pierwsza: identyfikuje krytyczne procesy, kwantyfikuje wpływ finansowy przestoju i produkuje metryki, z których powinna płynąć każda decyzja o site i backupie.
Te metryki to RTO i RPO. Recovery Time Objective to maksymalny akceptowalny downtime, zanim usługa musi wrócić online. Recovery Point Objective to maksymalna akceptowalna utrata danych mierzona czasem — jak stare mogą być odzyskane dane? System payroll z RTO 24 godziny i RPO 1 godzina oznacza: musisz działać w ciągu doby i nie możesz stracić więcej niż sześćdziesiąt minut edycji payroll. Częstotliwość backupu, interwał replikacji i strategia site wynikają z tych liczb — nie odwrotnie. Trwały dystraktor: traktować RTO i RPO jak wymienne. RPO rządzi tym, ile danych możesz stracić; RTO — jak długo możesz być offline. Pomyl je, a zaprojektujesz zły harmonogram backupu.
Hot, warm i cold sites
Site’y zapasowe pojawiają się w pytaniach o ciągłość, odzyskanie po ransomware i samodzielnych checkach słownictwa. Egzamin oczekuje znajomości trzech tierów przez tradeoffy recovery, nie tylko nazw.
Hot site to w pełni wyposażone, ciągle synchronizowane lustro środowiska primary. Serwery chodzą, dane są aktualne, failover kończy się w minutach do godzin. To najszybsza opcja recovery i najdroższa — płacisz za idle capacity, której masz nadzieję nigdy nie użyć. Hot site ma sens, gdy RTO liczy się w godzinach, a biznes nie zniesie sensownego przestoju: trading, payment processors, systemy healthcare działające non-stop.
Warm site ma infrastrukturę fizyczną — zasilanie, sieć, hardware — ale dane trzeba przywrócić z backupu, zanim site obsłuży produkcję. Failover zajmuje godziny do kilku dni zależnie od wolumenu i świeżości backupu. To pragmatyczny środek: wyraźnie tańszy niż hot, zdolny spełnić RTO 24–72h dla większości organizacji mid-market i realistyczny dla budżetów, z którymi architekci naprawdę pracują.
Cold site daje tylko przestrzeń fizyczną i podstawowe utilities. Wwozisz hardware, instalujesz software, przywracasz dane, zanim cokolwiek ruszy. Recovery zajmuje dni do tygodni. Cold site ma sens tylko wtedy, gdy RTO liczy się w dniach, a koszt przestoju mieści się w tolerancji — albo gdy use case to katastroficzny long-tail, a nie szybki failover.
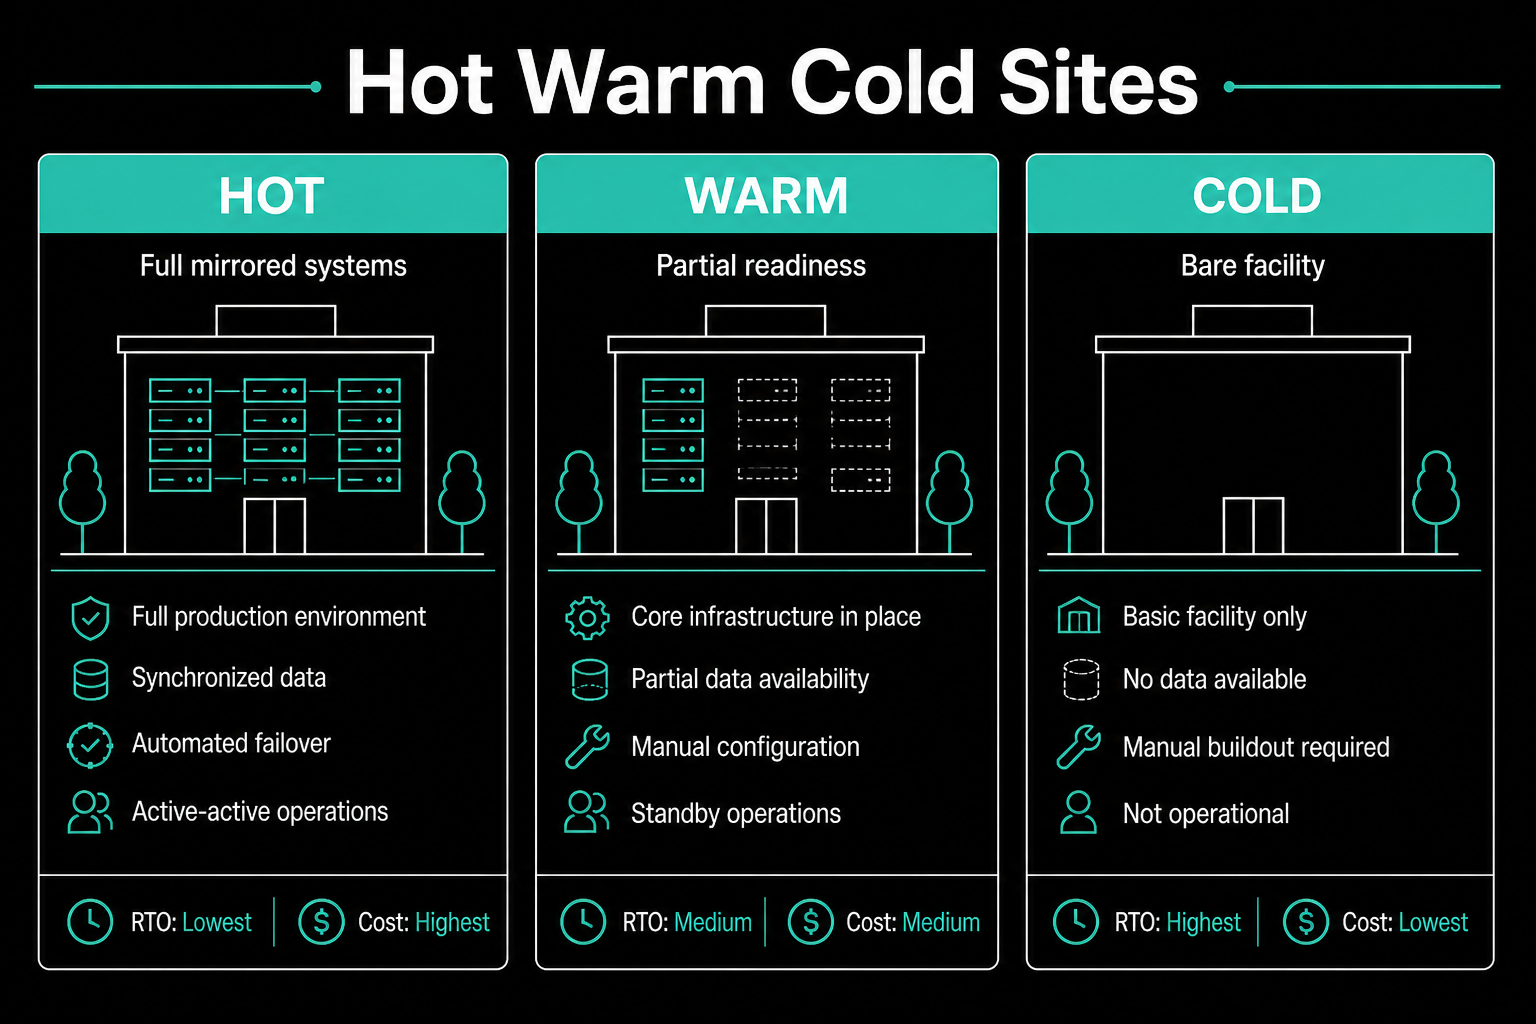
Dwie pułapki gromadzą się wokół pytań o site. Po pierwsze: traktować hot site jak równoważny zreplikowanym backupom — hot site to infrastruktura operacyjna, a replikacja lustrowa zaszyfrowanych plików w czasie rzeczywistym propaguje ransomware tak samo wiernie jak dane legalne. Po drugie: wybierać tier site tylko według kosztu — właściwy tier to ten, którego zdolność recovery pasuje do zobowiązania RTO z BIA. Cold site przy RTO 4 godziny zapisanym w BCP to porażka governance w budżetowym przebraniu.
Backupy jako kontrolka bezpieczeństwa
Backupy bronią przed ransomware, przypadkowym skasowaniem i korupcją — ale tylko gdy mają właściwości, które SY0-701 teraz podkreśla. Nieprzetestowany backup to wishful thinking: nie wiesz, czy restore działa, ile trwa i czy dane są intact, dopóki nie odpalisz restore. Backup na tej samej domenie co chronione systemy to autostrada ransomware — grupy rutynowo enumerują i niszczą infrastrukturę backupu przed odpaleniem encryptora.
Reguła 3-2-1 łapie minimum: trzy kopie, dwa typy mediów, jedna kopia offsite. Nowoczesna obrona przed ransomware pcha dalej ku przynajmniej jednej kopii immutable albo offline — object storage z object lock, taśma fizycznie odłączona od sieci albo tier snapshotów, którego admini backupu nie mogą zmienić po utworzeniu. Granica credentiali ma znaczenie większe, niż większość teamów przyznaje: operatorzy ransomware często osiągają dostęp domain-level przed encryptorem, a shared domain trust oznacza, że backup NAS jest osiągalny tą samą ścieżką co file serwery. Osobne credentiale, osobna management plane albo izolacja cloud-tier z dostępem tylko przez MFA to odpowiedzi architektoniczne, które egzamin nagradza.
Ransomware w piątek: pełny scenariusz
Ransomware szyfruje file serwery o 18:00 w piątek. Nocne backupy idą na NAS w tej samej domenie Active Directory. Snapshoty są widoczne i modyfikowalne ze standardowych kont file admin.
Porażki są architekturą, nie pechiem. Shared domain trust oznacza, że ransomware z dostępem domain-level sięga targetu backupu tą samą ścieżką credentiali. Harmonogram nocny oznacza RPO do 23 godzin. Nie ma tieru immutable/offline, więc opcja „przywróć z backupu” mogła sama zostać zaszyfrowana. Brak przetestowanej procedury restore oznacza, że nikt nie wie, ile naprawdę trwa odtworzenie trzech file serwerów — a odpowiedź może przekroczyć zobowiązanie RTO.
Silna odpowiedź zaczyna od izolacji sieci, zanim szyfrowanie się rozleje. Zachowaj pamięć i dysk, jeśli wymagania prawne lub forensyczne obowiązują. Zidentyfikuj ostatni znany czysty backup, potwierdź, że poprzedza okno infekcji, i odpal test restore na jednym izolowanym serwerze przed masowym recovery, by sprawdzić integralność. Przebuduj infrastrukturę tożsamości, jeśli credentiale domeny były skompromitowane — reimage serwerów nie unieważnia credentiali, które atakujący już ma. Podłączaj systemy dopiero po załataniu wektora initial access i walidacji braku persistence. Użyj drzewa kontaktów BCP do komunikacji statusu, nie potencjalnie skompromitowanego serwera poczty.
Słaba odpowiedź to natychmiastowa zapłata okupu albo reboot i nadzieja. Żadne nie daje czystego stanu, którego broniłbyś przed audytorem, i żadne nie zamyka ścieżki dostępu, którą atakujący użyje ponownie.
Podsumowanie pułapek egzaminacyjnych
| Pułapka | Reality check |
|---|---|
| „Hot site znaczy świetne backupy” | Hot site to infrastruktura operacyjna; replikacja real-time może lustrzać ransomware natychmiast |
| „Replikacja liczy się jako pokrycie RPO” | Replikacja real-time nie ma recovery point — potrzebujesz snapshotów point-in-time |
| „Clear wipe wystarczy na zwrócony dysk z leasingu” | Dane opuszczające org potrzebują Purge lub Destroy wg SP 800-88 |
| „KMS i HSM to to samo” | KMS zarządza cyklem w skali; HSM daje storage kluczy odporny na tamper — często razem, nigdy identyczne |
| „RTO i RPO to oba o czasie” | RPO to tolerancja utraty danych; RTO to tolerancja downtime — pomyl je i zaprojektujesz złą częstotliwość backupu |
| „Cold site jest OK, bo tańszy” | Tier site musi pasować do RTO; tani site przy RTO 4h to porażka governance |
| „Multi-pass overwrite na SSD działa jak na HDD” | Wear-leveling pokonuje overwrite na flashu; do purge SSD użyj cryptographic erase |
| „Szyfruj wszystko” rozwiązuje data minimization | Szyfrowanie chroni poufność; nie redukuje bezprawnego zbierania |
| „Backupy istnieją, więc ransomware jest zarządzalne” | Tylko jeśli są immutable, izolowane od domeny i przetestowane — nic z tego nie jest automatyczne |
Zamknięcie
Ochrona danych i odporność nie są osobnymi domenami zszytymi na siłę — to ta sama historia opowiedziana w różnych skalach czasu. Klasyfikacja mówi, co ma znaczenie. Szyfrowanie, DLP i key management chronią, gdy dane żyją. NIST SP 800-88 ogarnia utylizację, gdy hardware odchodzi. RTO i RPO tłumaczą tolerancję biznesu na częstotliwość backupu i tier site. Immutable backupy z przetestowanym restore zamieniają ransomware z zagrożenia egzystencjalnego w udokumentowane odzyskanie.
Do przeczytania obok: post o reagowaniu na incydenty i zarządzaniu podatnościami pod godziny po odpaleniu detekcji oraz post o IAM, monitoringu i hardeningu pod kontrolki tożsamości i logowania leżące upstream od dostępu do danych.